传统代码高亮陷入两难:Prism/Highlight.js 正则方案轻量但易在嵌套语法翻车;VS Code 级的 Shiki/Starry Night 虽然精准,但需塞入动辄数百 KB 至数 MB 的 TextMate 规则与 WASM 语法包。
Vercel Labs 的 Shu Ding 搞了个新物种「gpu-lexer」:彻底废弃每门语言维护一套语法包的传统做法,用一个微型 WebGPU 模型取代手写规则。
🔍 核心亮点与实测数据:
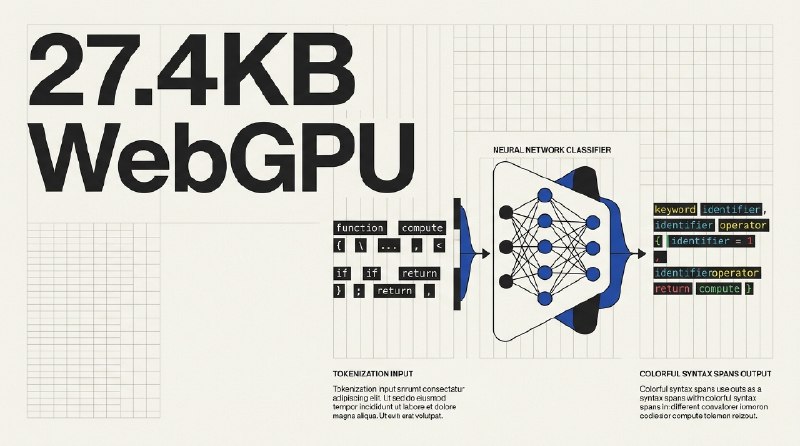
• 微型模型:仅 41,321 个参数(packed int6 压缩后 31KB,总包 27.4KB),将语法规则“学”进权重,在浏览器跑 WebGPU 推理。
• 91+ 语言泛化:把源码切成基础单元,结合上下文直接预测 9 类语法标签。遇到从未训练过的冷门语言也能结合上下文推测,原生支持 Vue/Svelte 嵌套块。
• 70 倍速度碾压:官方基准(M4 Pro 跑 5.56M 字符 three.min.js),gpu-lexer 耗时 402ms,而 Shiki 耗时 29.6s!
• 一致性表现:在 GitHub Top 25 主流语言验证集上,与 Shiki 的标签一致率为 90.35%(高于 Prism 的 86.9%)。
💡 Agili 犀利点评:
思想极其性感!它颠覆了高亮器“语法树硬解析”的惯性思维,展示了小模型在垂类任务上的降维打击。但要清醒看到约束:它属于概率推测(保留测试集存在约 12% 标签差异),不能当编译器或 Linter 的严谨词法分析;且重度依赖客户端 WebGPU。极度适合轻量文档站、在线预览与快速嵌入场景。
🔗 原文:https://gpu-lexer.vercel.app/
