在 RAG 与数据清洗中,把复杂排版 PDF/翻拍图片解析成 Markdown 一直受困于级联误差。传统多模型流水线(版面分析+切图OCR+公式表格拼装)极易步步错;调千亿通用大模型又太贵且小字易漏。
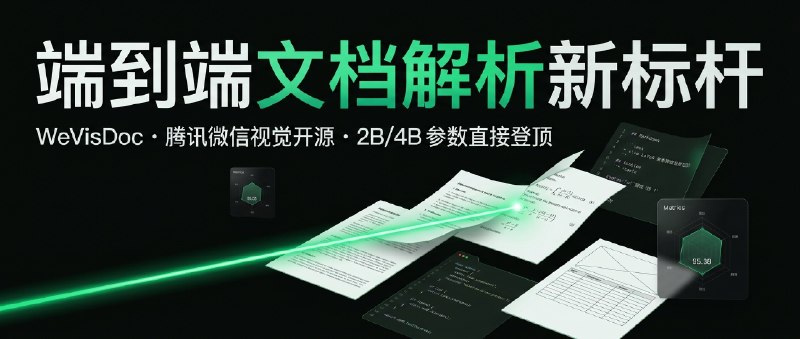
腾讯微信视觉团队开源了 WeVisDoc(基于 Qwen3-VL-2B/4B),给出了高性价比单模型端到端解法:输入单页图片,直接输出含 LaTeX 公式与 HTML 表格的结构化 Markdown。
核心亮点:
• 🏆 双榜登顶:WeVisDoc-4B 在 OmniDocBench v1.6 拿下 95.38(公式 CDM 96.81,表格 TEDS 95.34);PureDocBench 三赛道均分 75.54,力压 HunyuanOCR、DeepSeek-OCR 2、Qianfan-OCR,甚至跑赢 Qwen3.5-122B 等超大模型。
• 📦 小体量高精度:2B 版本在 OmniDocBench 同样砍下 95.06,低显存也能跑出顶尖水准。
• 🎯 两阶段残差精修:Stage I 融合 4000 万样本与结构保真退化合成;Stage II 用独立探针聚类残差错误(数独漏检、读序错乱、公式截断等)重配 Token 预算,在真实翻拍赛道暴涨 4.03 分。
• 🚀 原生支持 vLLM:自带生产级 vLLM 脚本与 OpenAI 兼容接口,支持多卡张量并行与高并发批量解析。
避坑与边界:
• 接收单页光栅图(PNG/JPEG/WebP),PDF 需先转图(建议 200~300 DPI);
• 默认忽略页面插图,仅还原文本、公式与表格;
• 狂草手写体或严重污损古籍仍有局部字级误差。
Agili 点评:
端到端模型在复杂文档翻车,瓶颈不在架构,在于训练数据的长尾失衡。WeVisDoc 用诊断探针闭环把 4B 小模型潜力榨干,搭 RAG 或洗语料直接用 vLLM 起一个,精度与吞吐都无可挑剔。
GitHub:https://github.com/Tencent/WeVisDoc
Demo:https://tencent.github.io/WeVisDoc
